Sobre la predicción de la conducta individual y colectiva, y el por qué fallan las encuestas electorales.
Quienes trabajamos e investigamos sobre conductas colectivas convivimos con una pregunta que nos hacen de mil maneras distintas.
Además, quieren saber cuánto tiempo antes se puede anticipar lo que hará determinado grupo de personas.
Hoy en los medios preguntan qué va a hacer la gente, especialmente durante las elecciones.
La respuesta corta tiene dos partes. Los individuos somos bastante más predecibles de lo que nos gusta admitir.
La conducta colectiva en elecciones, el terreno donde se invierte más dinero en predicción, sigue provocando “sorpresas” que los modelos no logran anticipar como nos gustaría.
Para cumplir con los lectores frecuentes, voy a proponerles recorrer la evidencia disponible sobre ambas respuestas. Así podremos cerrar con la pregunta que quizá no se han hecho, pero que considero igualmente importante para entender hacia dónde se dirige hoy la cuestión y qué efectos podría tener en el desarrollo de las estrategias electorales.
La pregunta a responder es qué herramientas concretas se usan en consultoría política hoy para trabajar y qué se puede esperar de ellas en elecciones. En este análisis, se examinarán métodos analíticos, plataformas de monitoreo y estrategias de comunicación que influyen en las decisiones de los actores y en la percepción pública, con ejemplos de resultados posibles y límites prácticos para las elecciones.
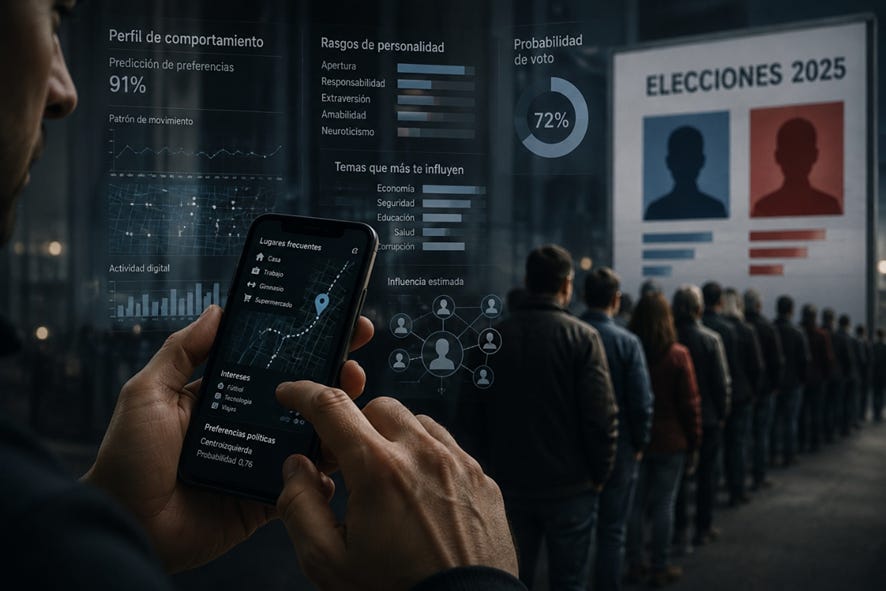
En 2010, un equipo dirigido por el físico Albert-László Barabási publicó en Science un estudio que se volvió referencia obligada. Analizaron los registros anónimos de 50.000 usuarios de telefonía celular durante tres meses y midieron con la información de todos los trayectos registrados la entropía de sus trayectorias, es decir, cuánta es la incertidumbre real para predecir dónde estarán tal día y a tal hora, o bien establecer el recorrido probable, incluso en elecciones.
El resultado mostró que existe una posibilidad del 93% de poder predecir correctamente. Este hallazgo ha sido citado para destacar el grado de predictibilidad de trayectorias humanas basadas en datos móviles. Implica que, bajo ciertas condiciones, se puede estimar con precisión el recorrido probable de individuos para fines analíticos y de planificación.
Un algoritmo que conozca el historial completo de movimientos de una persona puede, en el mejor de los casos, acertar su ubicación en la hora siguiente el 93% de las veces. El dato más llamativo fue la homogeneidad del hallazgo porque no hubo usuarios que rompieran su lógica de traslado o movimiento más allá del 20%, es decir que son pocos los que rompen rutinas. Eso además resultó independiente de si la persona se movía en un radio de diez kilómetros o recorría cientos de kilómetros regularmente.
Conviene aclarar qué significa ese 93%. El número habla de la regularidad de nuestras rutinas de viajes o traslados, del peso enorme de la casa, el trabajo y los pocos lugares que estructuran nuestra vida cotidiana.
Lo que asusta es que un teléfono que registra dónde estuviste durante meses permite anticipar dónde vas a estar. Eso es regularidad de hábitos pero está muy lejos de revelar las intenciones o razones de por qué hacemos lo que hacemos.
La predictibilidad tampoco se limita al movimiento. En 2013, Michal Kosinski y sus colegas de Cambridge demostraron con datos de 58.000 voluntarios que los “Me gusta” de Facebook alcanzaban para inferir posiciones y atributos que la persona no declara expresamente.
Su modelo distinguía a hombres homosexuales de heterosexuales en el 88% de los casos, a afroamericanos de caucásicos en el 95% y a demócratas de republicanos en el 85%.
Dos años después, otro estudio del mismo grupo comparó los juicios de personalidad de un algoritmo respecto de las personas que conocían a la persona que estaban evaluando. El algoritmo necesitó sólo 10 “Me gusta” para “conocer” la personalidad de alguien mejor que un compañero de trabajo, 70 “Me gusta” para superar a un amigo, 150 para superar a un familiar y 300 para superar a la pareja.
Con la cantidad de “Me gusta” que clickea un usuario promedio, la precisión del modelo alcanzaba una correlación de 0,56 con lo que la persona dice de sí misma, contra 0,49 del “juez” humano promedio. Para ser claros, una correlación de 0,56 es alta para los estándares de la psicología, aunque no implica certeza. Puede describir tendencias que funcionan sobre agregados grandes (grupos) pero se equivoca seguido en el caso individual.
Lo sorprendente, sobre todo en esta época de sobre existencia de videovigilancia y la posibilidad de reconocimiento facial, se relaciona con nuestra cara, o rostro, si se prefiere precisión conceptual.
En 2024, Kosinski publicó con dos colegas de Stanford un experimento en American Psychologist. Fotografiaron en el laboratorio a 591 participantes con expresión neutra, controlando la pose, el arreglo personal y las propiedades de la imagen. Un algoritmo de reconocimiento facial predijo la orientación política autodeclarada con una correlación de 0,22. Algo similar a lo que lograron evaluadores humanos mirando las mismas fotos. Sin embargo, fue del 0,31 cuando se sumaron los datos de edad, género y etnia.
Los autores comparan la magnitud de esto con la capacidad de una entrevista laboral para predecir el desempeño futuro en el trabajo. Se trata de un efecto real a escala estadística y débil a escala individual, pero eso no lo vuelve inocuo. Aplicada sobre millones de rostros, que ya tienen disponibles las redes sociales, porque de forma voluntaria le proveemos mucho de eso, podría producir clasificaciones masivas sin consentimiento adicional de nadie, y esa posibilidad debería pesar en cualquier discusión seria sobre el reconocimiento facial en la actualidad y la vigilancia estatal. Me refiero a que si nuestros datos importan y valen, el caso de la identidad visual es aún más sensible.
Todo lo anterior funciona sobre el supuesto de que el futuro se parece al pasado. Los modelos que predicen conducta individual trabajan sobre rutinas y se degradan cuando la rutina se rompe. Por ejemplo en lo casos donde se cambia de trabajo, de ciudad, de circunstancias familiares, etc. La pandemia del COVID19, para citar un caso excepcional, es un gran disruptor de la predictibilidad.
Un estudio publicado en 2025 mostró que la mejor manera de predecir la conducta individual fuera de rutina consiste en incorporar los factores de la conducta colectiva como dato complementario. Cuando un individuo se vuelve errático, el comportamiento del grupo que recorre los mismos lugares recupera buena parte de la capacidad predictiva perdida. Esta lógica ya se había observado en catástrofes.
Tras el terremoto de Haití de 2010, un equipo del Instituto Karolinska analizó los desplazamientos de 1,9 millones de usuarios por la ubicación de teléfonos celulares y encontró que, conociendo los movimientos de una persona durante los primeros tres meses posteriores al sismo, su ubicación en el período siguiente podía predecirse con un 85% de probabilidad.
¡Sí! Aun huyendo de una catástrofe nos movemos hacia lugares que ya conocemos. El agregado de cómo se comporta el grupo al que pertenecemos estabiliza lo que el individuo desordena.
Si el agregado estabiliza, el electorado (conjunto de votantes) deberían ser el caso fácil teniendo en cuanta que tenemos millones de personas como universo de casos agregados, una conducta limitada a pocas opciones electorales y mediciones constantes durante meses. Sin embargo, las predicciones fallan y por mucho.
Aunque hay que decir que las causas no son propias de imprevisibilidad, sino de problemas técnico metodológicos que conocemos o sufrimos quienes hemos trabajado con encuestas y datos relacionados. Muestras que en realidad no son aleatorias como se debería, reclutadas online o por teléfono sin criterios duros, tasas de no respuesta cada vez más altas en todo el mundo, un porcentaje de indecisos difícil de proyectar cuando aparece un candidato sin historia electoral (outsider) y un voto vergüenza que la gente pretende ocultar y no declara abiertamente. Cabe aclarar que detrás de esa lista hay un problema conceptual que me parece más interesante que cada uno de esas fallas puntuales.
Una encuesta mide la conducta declarada por el (sub) conjunto de personas que SÍ acepta responder. Si los que NO quieren responder se parecieran a los que responden, la corrección estadística alcanza. Pero, por ejemplo, cuando el enojo con la política es a la vez una variable adicional que explica el voto y a la vez la negativa de atender al encuestador, el instrumento no sirve porque no es capaz de obtener la información necesaria.
Hay una segunda capa que conecta con los estudios de movilidad que mencionamos. Una elección con un candidato nuevo, sobre todo disruptivo, es por definición una conducta fuera de la rutina. Los modelos se entrenan con el historia electoral por eso fallan cuando la historia deja de ser representativa, justo cuando más importa e interesa acertar.
La paradoja es dura para la consultoría política. Porque la predicción rinde al máximo en los escenarios estables, donde se supone que menos se la necesitaría, y sirve de poco en escenarios de cambio, donde todos pagan por tener una encuesta que permita conocer de antemano “lo que va a pasar”.
Con ese telón de fondo, y habiéndome ganado el enojo de los encuestadores, quiero compartir la caja de herramientas que se utiliza para realizar parte de ese trabajo en la actualidad, que tiene menos glamour que el que se muestra en el cine.
La base sigue siendo la investigación clásica, encuestas con diseños cada vez más cuidados para compensar la “no respuesta” y estudios cualitativos que ayudan a entender lo que los números describen sin explicar. Durante la última década y de la mano del desarrollo tecnológico, en especial la IA, y la enorme disponibilidad de datos se agregó una capa tecnológica poco conocida para quienes son ajenos al oficio.
Las plataformas de escucha social, con productos como Brandwatch, YouScan o Brand24 entre muchos otros, procesan menciones públicas en redes y medios para detectar narrativas emergentes, medir el clima de la conversación digital y anticipar crisis reputacionales. Funcionan bien como “alerta temprana” pero funcionan mal como termómetro electoral, porque la conversación digital sobrerrepresenta a los usuarios más intensos y no se distribuye de la misma manera que el padrón electoral.
En Estados Unidos existe una industria de datos electorales que no existe en latinoamérica. Empresas como L2 comercializan archivos con 217 millones de votantes registrados y cientos de atributos demográficos, de consumo y de comportamiento por persona. Esos archivos se cruzan con plataformas de gestión de campaña como NGP VAN o NationBuilder, que organizan “el puerta a puerta”, las llamadas y el pedido de donaciones combinado con sistemas de publicidad programática como Google Display & Video 360, que permiten mostrar avisos distintos a diferentes segmentos del electorado.
En Argentina y en buena parte de América Latina, con marcos legales, mercados de datos y capacidades estatales muy diferentes según el país, el trabajo es bastante más artesanal y descansa en encuestas, seguimiento de redes, segmentación geográfica y mucha interpretación situada, es decir “oficio”.
Lo más publicitado es también lo más discutible.
En 2017, Sandra Matz y sus colegas incluyeron en la publicación oficial de la Academia Nacional de Ciencias de los Estados Unidos (PNAS), los resultados de experimentos, que incluyeron a más de 3,5 millones de personas, en lo que se comprobó que los anuncios ajustados al perfil psicológico del receptor generan más clics y más compras que los genéricos, parece obvio pero es bueno tener la comprobación.
Ese hallazgo, legítimo y acotado al marketing, alimentó la leyenda del caso “Cambridge Analytica”, la consultora que en 2018 quedó en el centro del escándalo global por haber accedido a datos de decenas de millones de perfiles de Facebook y que según varios medios se utilizaron en campañas para manipular a electores en distintos países, entre ellos Argentina.
No obstante, el gobierno británico, por medio de la autoridad de protección de datos investigó a la empresa durante años, examinó sus servidores y concluyó que sus métodos eran en gran medida los habituales de la industria publicitaria y que en realidad habían sobrevendido la eficacia de su segmentación psicográfica. Eso si, el acceso indebido a los datos fue real y grave. La “máquina de manipular votantes” que la empresa vendía nunca pudo demostrarse que existiera y/o funcionara.
La evidencia académica sobre persuasión electoral fue aportada, entre otros, por Joshua Kalla y David Broockman quienes revisaron 49 experimentos de campo y estimaron que el efecto persuasivo promedio del contacto de campaña en las elecciones generales estadounidenses “es indistinguible de cero”. Pero sí encontraron efectos donde se daban condiciones poco frecuentes, como en primarias (alcance restringido), en temas sin anclaje partidario o cuando las campañas invierten mucho en identificar al pequeño grupo de votantes “persuadibles”.
La evidencia indica que las campañas políticas mueven poco la opinión pública de los electores, pero influyen mucho sobre la participación, sobre la cantidad de ciudadanos que se movilizan o no para ir a votar.
Por eso, y para no pisar sábanas entre fantasmas, hay que decir que identificar al votante propio, sostener el vínculo y lograr que vaya a votar, sobre todo en una elección que se define por dos puntos, es la diferencia que justifica toda la inversión que se haga.
La predicción algorítmica rinde donde la rutina es la norma. Por ello, plataformas de compras como Amazon o Mercado Libre sabrá cual es tu próxima compra cuanto más las utilices. Eso no significa que la certeza del 100% sea alcanzable, es probable que tu cuenta también la utilices para comprar algo para otros y ahí es donde comienza a complicarse.
En el caso de La Política, la cuestión es más sensible, porque como anticipamos antes, la predicción se vuelve muy importante cuando la “rutina” se rompe, cuando el escenario electoral difiere con respecto a los anteriores. Algo que ocurrió mucho después de la pandemia del COVID19 en varios países del mundo, sus sistemas políticos y elecciones.
El residuo que los modelos matemáticos reconocen como “ruido” se vuelve un condicionante muy fuerte para predecir. Ese “ruido” puede ser el efecto del votante enojado que no atiende encuestadores, el candidato “outsider” que no tenía similares en la serie histórica o una crisis que reordena prioridades, entre otros posibles ejemplos. Y ese o esos “detalles” son precisamente lo que termina definiendo el resultado electoral.
Particularmente hay que desconfiar tanto del relato de la “omnisciencia”, desde el cual muchos aseguran que los datos disponibles hoy permiten saber cómo vamos a votar mañana, como del relato de la “irrelevancia”, que descarta estas herramientas porque las consideran “humo” de los consultores políticos.
A esta altura quiero agregar una cuestión que me parece clave, sobre todo para el futuro de la democracia. Existe un riesgo verificable y estructural en que las empresas e instituciones públicas, que recolectan y compilan datos, saben mucho más del ciudadano, que lo que nosotros sabemos de ellas. Y esa capacidad, en especial la de analizar con herramientas potentes, se concentra en actores con el poder económico suficiente para pagarla mientras que el marco regulatorio corre desde muy atrás generando vacíos demasiado permisivos y una desigualdad potencial inadmisible.
Volviendo al eje central de esta nota, se puede decir que, hasta hoy, la conducta humana es predecible sólo dentro de los límites de lo rutinario. Por eso es recomendable entender lo que implican las probabilidades y los márgenes de error.
Quien en la actualidad ofrezca certezas, sobre todo respecto del comportamiento político, estará buscando clientes; mientras que quien las compre estará pagando por la respuesta que espera obtener.
Fuentes
Song, C., Qu, Z., Blumm, N. y Barabási, A.-L. (2010). Limits of Predictability in Human Mobility. Science. https://barabasi.com/media/2010-Song_et_al-Limits_of_Predctiability-Science.pdf
Kosinski, M., Stillwell, D. y Graepel, T. (2013). Private traits and attributes are predictable from digital records of human behavior. PNAS. https://www.pnas.org/doi/10.1073/pnas.1218772110
Youyou, W., Kosinski, M. y Stillwell, D. (2015). Computer-based personality judgments are more accurate than those made by humans. PNAS. https://www.pnas.org/doi/10.1073/pnas.1418680112
Kosinski, M., Khambatta, P. y Wang, Y. (2024). Facial recognition technology and human raters can predict political orientation from images of expressionless faces. American Psychologist. https://pubmed.ncbi.nlm.nih.gov/38512164/
Bontorin, S., Centellegher, S., Gallotti, R., Pappalardo, L., Lepri, B. y Luca, M. (2025). Mixing individual and collective behaviors to predict out-of-routine mobility. PNAS. https://www.pnas.org/doi/10.1073/pnas.2414848122
Lu, X., Bengtsson, L. y Holme, P. (2012). Predictability of population displacement after the 2010 Haiti earthquake. PNAS. https://www.pnas.org/doi/10.1073/pnas.1203882109
Matz, S. C., Kosinski, M., Nave, G. y Stillwell, D. J. (2017). Psychological targeting as an effective approach to digital mass persuasion. PNAS. https://www.pnas.org/doi/10.1073/pnas.1710966114
Kalla, J. y Broockman, D. (2018). The Minimal Persuasive Effects of Campaign Contact in General Elections: Evidence from 49 Field Experiments. American Political Science Review. https://www.cambridge.org/core/journals/american-political-science-review/article/abs/minimal-persuasive-effects-of-campaign-contact-in-general-elections-evidence-from-49-field-experiments/753665A313C4AB433DBF7110299B7433
Leiva, M. (2023). Ninguna encuesta pronosticó que Javier Milei obtendría el 30% de los votos: ¿por qué fallaron? Chequeado. https://chequeado.com/el-explicador/ninguna-encuesta-pronostico-que-javier-milei-obtendria-el-30-de-los-votos-por-que-fallaron/
TechCrunch (2020). Cambridge Analytica sought to use Facebook data to predict partisanship for voter targeting, UK investigation confirms. https://techcrunch.com/2020/10/06/cambridge-analytica-sought-to-use-facebook-data-to-predict-partisanship-for-voter-targeting-uk-investigation-confirms
L2 Data. Trusted Voter Records and Consumer Data. https://l2-data.com/

Politólogo, consultor político y especialista en seguridad vial, con más de veinte años de trayectoria en América Latina. Dirige la consultora EthosIA y es socio fundador de Grupo Siro. También es docente, conferencista y escritor, y dicta talleres de escritura creativa.